跳到主要内容

OpsPilot · 业务调查Operational Investigation

OpsPilot

AI 辅助业务调查工作台

将业务异常转化为有证据支撑的调查假设和受控行动。

业务调查Operational Investigation证据可追溯Evidence Traceability人工介入Human-in-the-loop系统评测System Evals
返回作品集
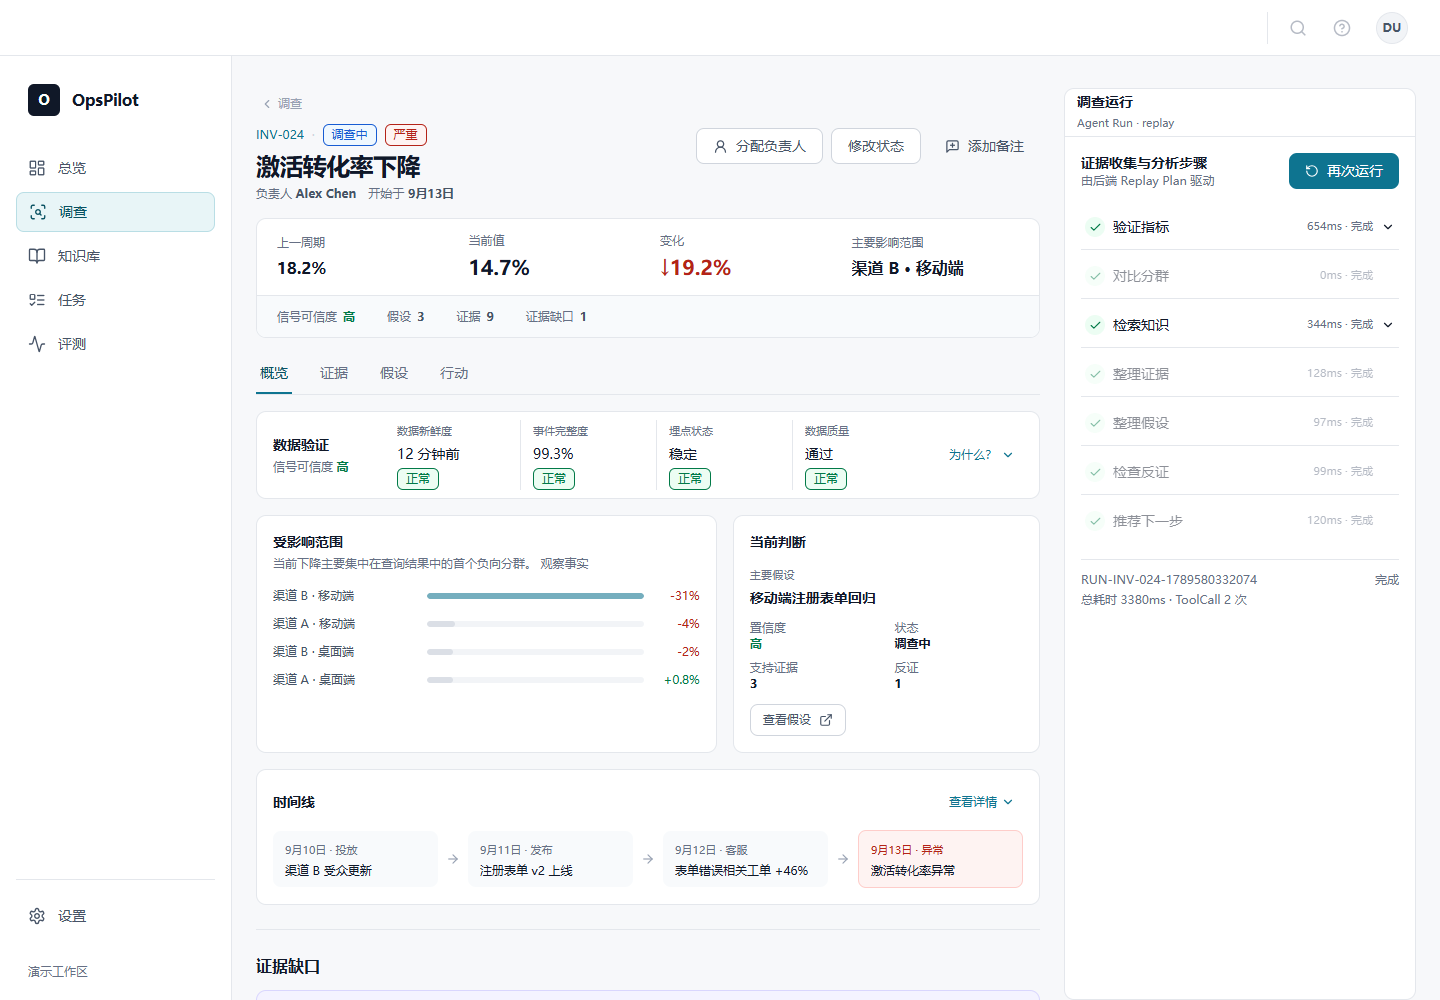
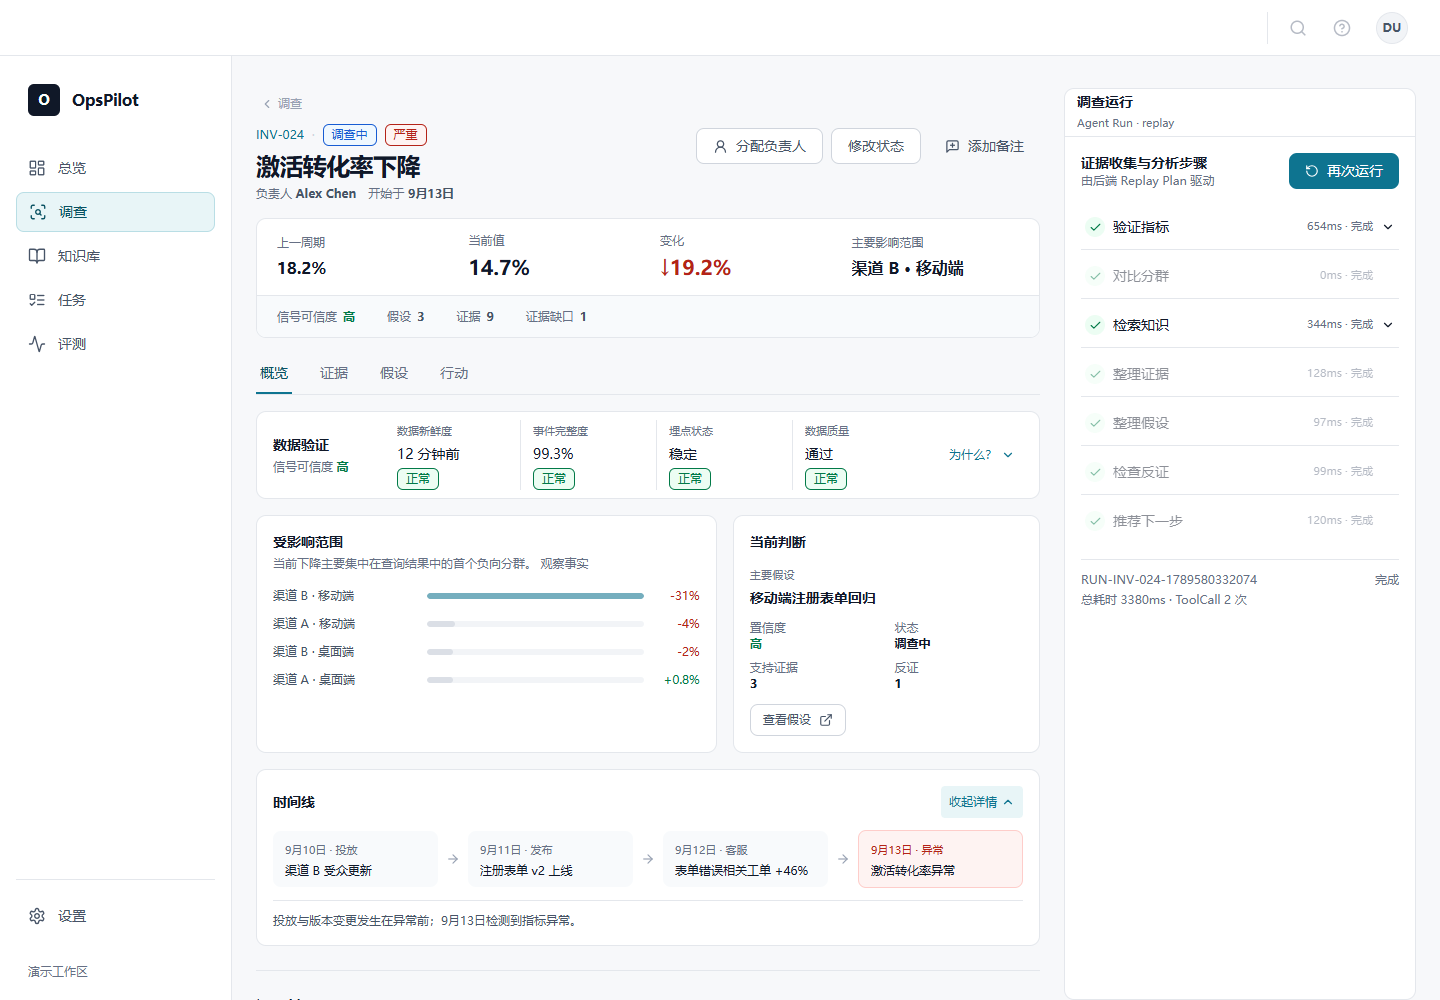
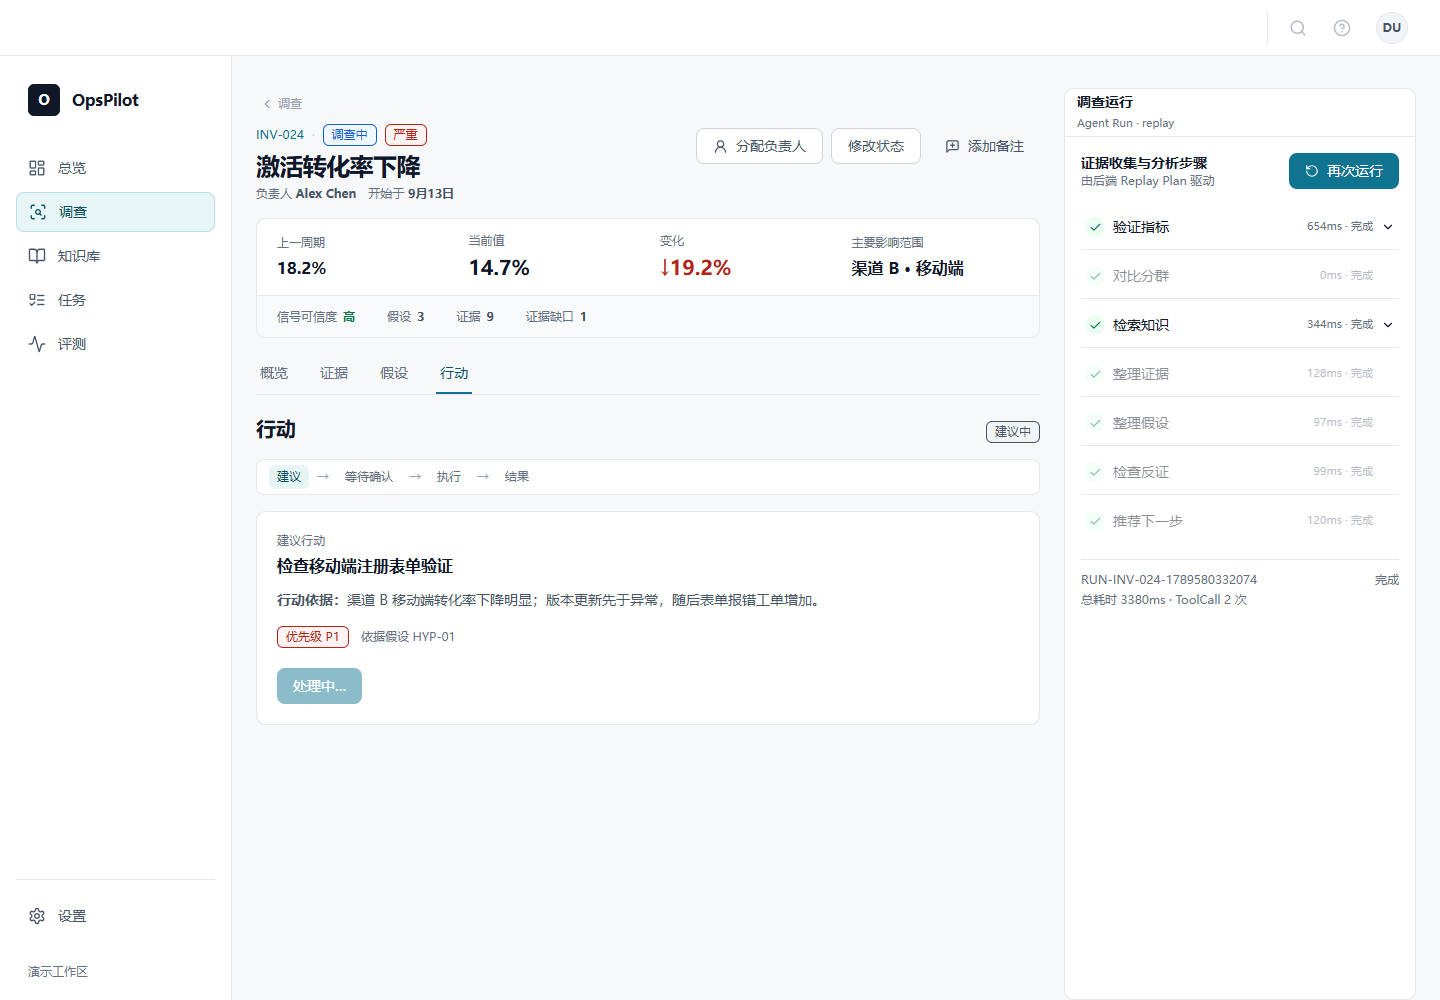
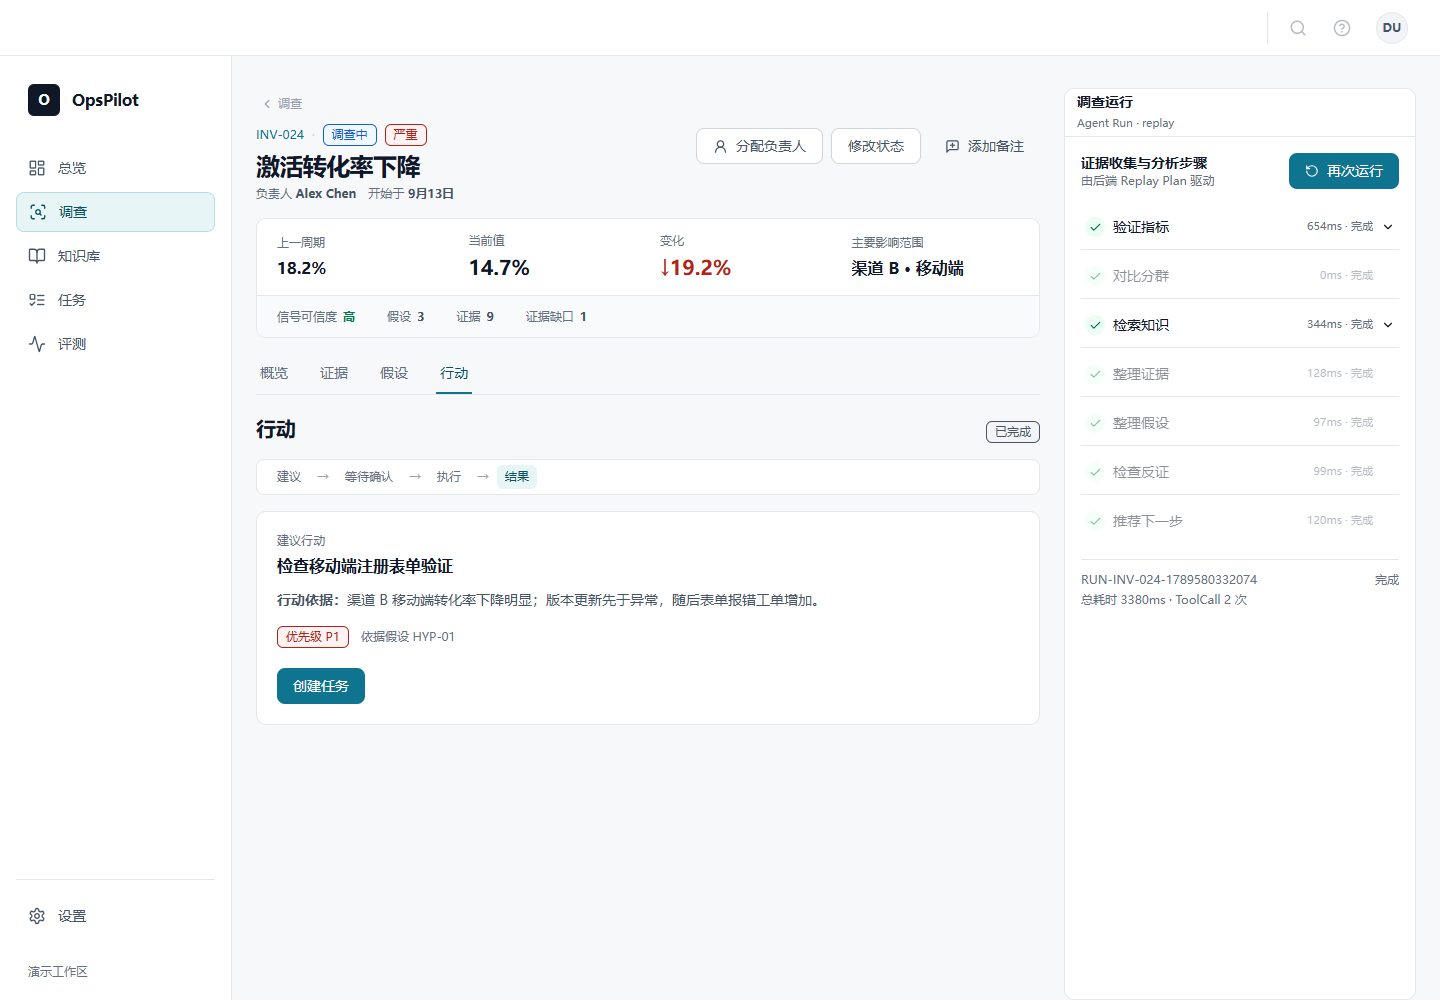
OpsPilot 调查详情与 Agent Panel 真实界面
真实产品界面 · INV-024 调查详情与 Agent Run
指标Metric证据Evidence假设Hypothesis行动Action结果Outcome

项目能力 Project Capabilities

从问题判断到可交付结果
产品定义 Product Definition
领域建模 Domain Modeling
智能体流程设计 Agent Workflow Design
AI 安全边界 AI Safety & Control
评测设计 Evaluation Design
AI 辅助实现 AI-assisted Implementation

01 · 问题与研究

业务团队知道“指标变了”,但很难快速回答“下一步该查什么”。

本项目基于公开社区与案头研究(Secondary / Community Research)和合成用户画像(Synthetic Personas)定义场景,不把它包装成真实企业访谈。

异常本身不是最难的问题。真正的成本来自跨工具重建上下文,并判断哪些信息足以支持下一步。

  • 01

    上下文分散

    指标、发布记录、客服反馈和业务文档分散在多个工具中。

  • 02

    调查成本高

    团队需要手动比对时间线、分群和业务变更。

  • 03

    业务记忆薄弱

    过去发生过的类似问题很难被系统化复用。

  • 04

    证据不确定

    相关信息容易被直接当成结论,缺少来源与可信度约束。

JTBD

当关键业务指标发生异常变化时,帮助我验证信号、重建周围上下文、评估可能解释并决定下一步调查方向,而不需要在多个工具之间手动拼接证据。
发现验证定位重建上下文提出假设验证交接行动观察结果

02 · 产品定义

我没有把它设计成“聊天机器人”。

OpsPilot 的核心对象是 Investigation(调查)。结构化对象让事实、解释、决策和结果可以被追踪、复用与评测。

核心对象

调查Investigation

不是

聊天Chat一次性聊天答案
指标Metric调查Investigation证据Evidence假设Hypothesis建议Recommendation行动Action结果Outcome
辅助对象时间线事件Timeline Event证据缺口Evidence Gap
先证据,后解释Evidence before explanation
假设不是结论Hypothesis is not conclusion
AI 提出建议,人工决定执行AI recommends, humans authorize
智能体行为应该可以被评测Agent behavior should be evaluable

03 · 核心调查流程

先验证数据,再讨论原因。

Golden Case 围绕 INV-024:激活转化率下降。系统先验证数据质量、比较周期并定位分群,再进入证据和假设。

上一周期18.2%
当前值14.699%
变化−19.2%
主要影响范围渠道 B · 移动端Channel B · Mobile约 −31%
数据质量Data Quality通过pass
query_metrics Tool Detail 与指标分析真实界面
query_metrics · 数据质量 → 周期对比 → 分群定位Data Quality → Period Comparison → Segment Comparison

计算依据SUM(numerator) / SUM(denominator)

禁止平均 Segment Percentage
渠道 B 投放调整Campaign ChangeSignup Form v2 上线Product Release移动端注册问题反馈增加Support Signal Increase激活转化率异常Metric Anomaly

时间线事件 ≠ 调查证据Timeline Event ≠ Evidence事件记录发生了什么;只有与调查建立明确来源关系后,才成为证据。

04 · 知识到证据

检索到相关内容,不等于获得事实。

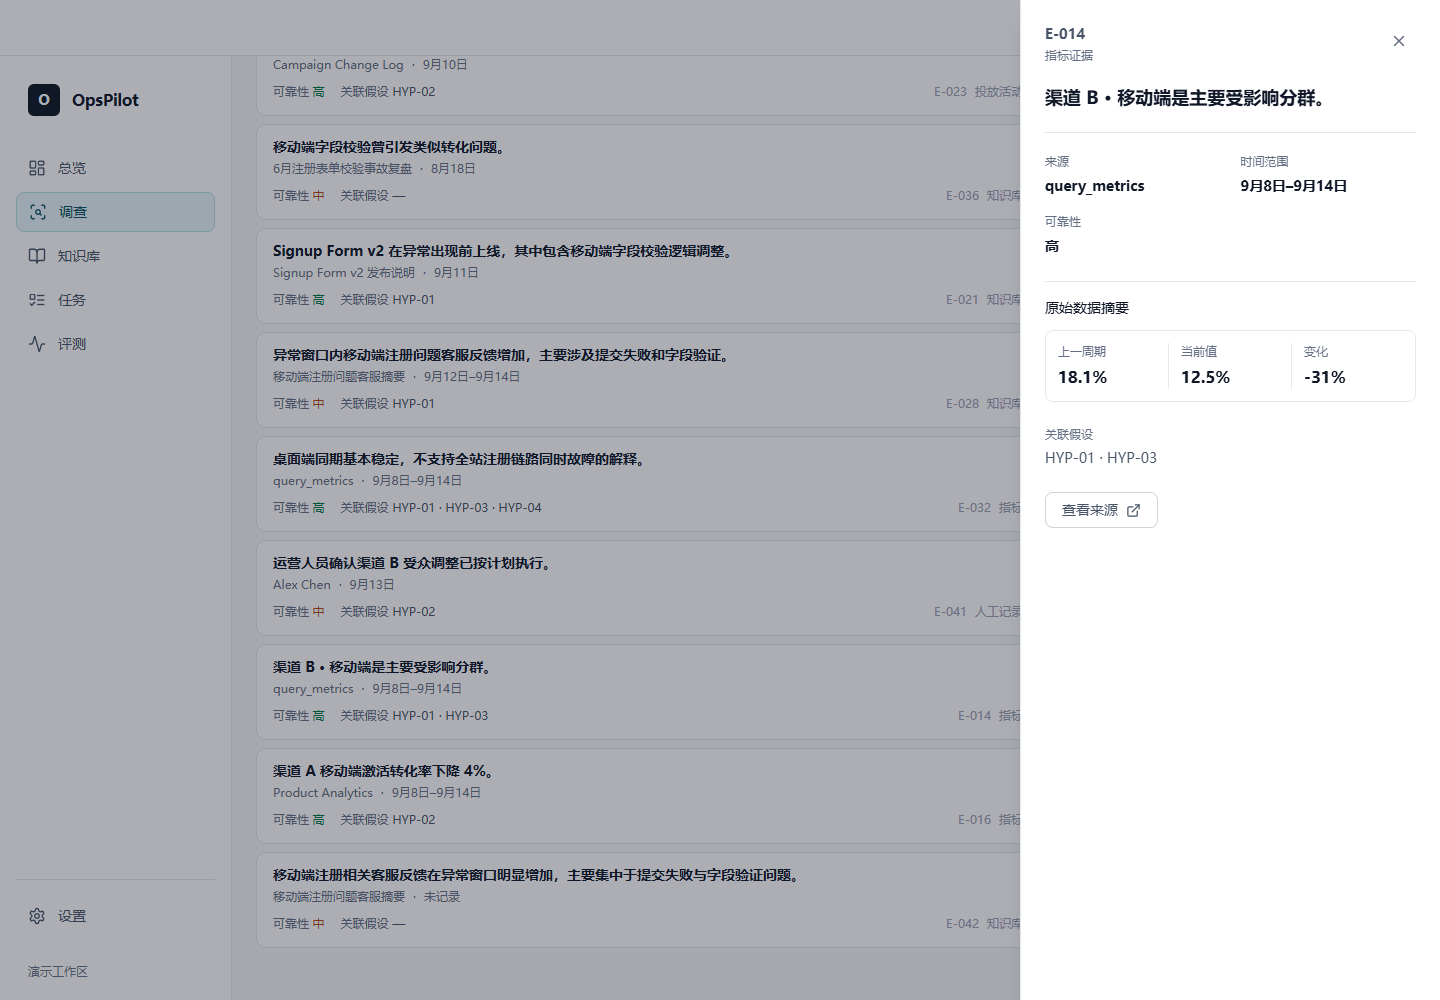
search_knowledge 找到上下文和引用,但检索结果不会直接升级为正式证据。

OpsPilot Evidence Drawer 与 Citation 真实界面
真实引用界面 Citation UI · 文档 / 分块 / 时间 / 可靠性

检索问题Query

移动端注册表单异常

  • DOC-002 移动端注册问题客服摘要
  • DOC-001 Signup Form v2 发布说明
  • DOC-003 6月注册表单校验事故复盘
检索结果Knowledge Result候选证据Candidate Evidence人工确认Human Review正式证据Formal Evidence
E-014 · 高 High

渠道 B · 移动端是主要受影响分群。

query_metrics

E-021 · 高 High

Signup Form v2 在异常前上线,包含移动端字段校验调整。

DOC-001

E-028 · 中 Medium

异常窗口内,移动端注册相关客服反馈增加。

DOC-002

E-032 · 高 High

桌面端同期基本稳定,限制“全站故障”的解释。

query_metrics

05 · 假设设计

让 AI 提出假设,而不是宣布根因。

当前证据最支持“移动端注册表单回归”,但仍缺少直接错误日志;系统保留 Evidence Gap,而不把相关性升级成根因结论。

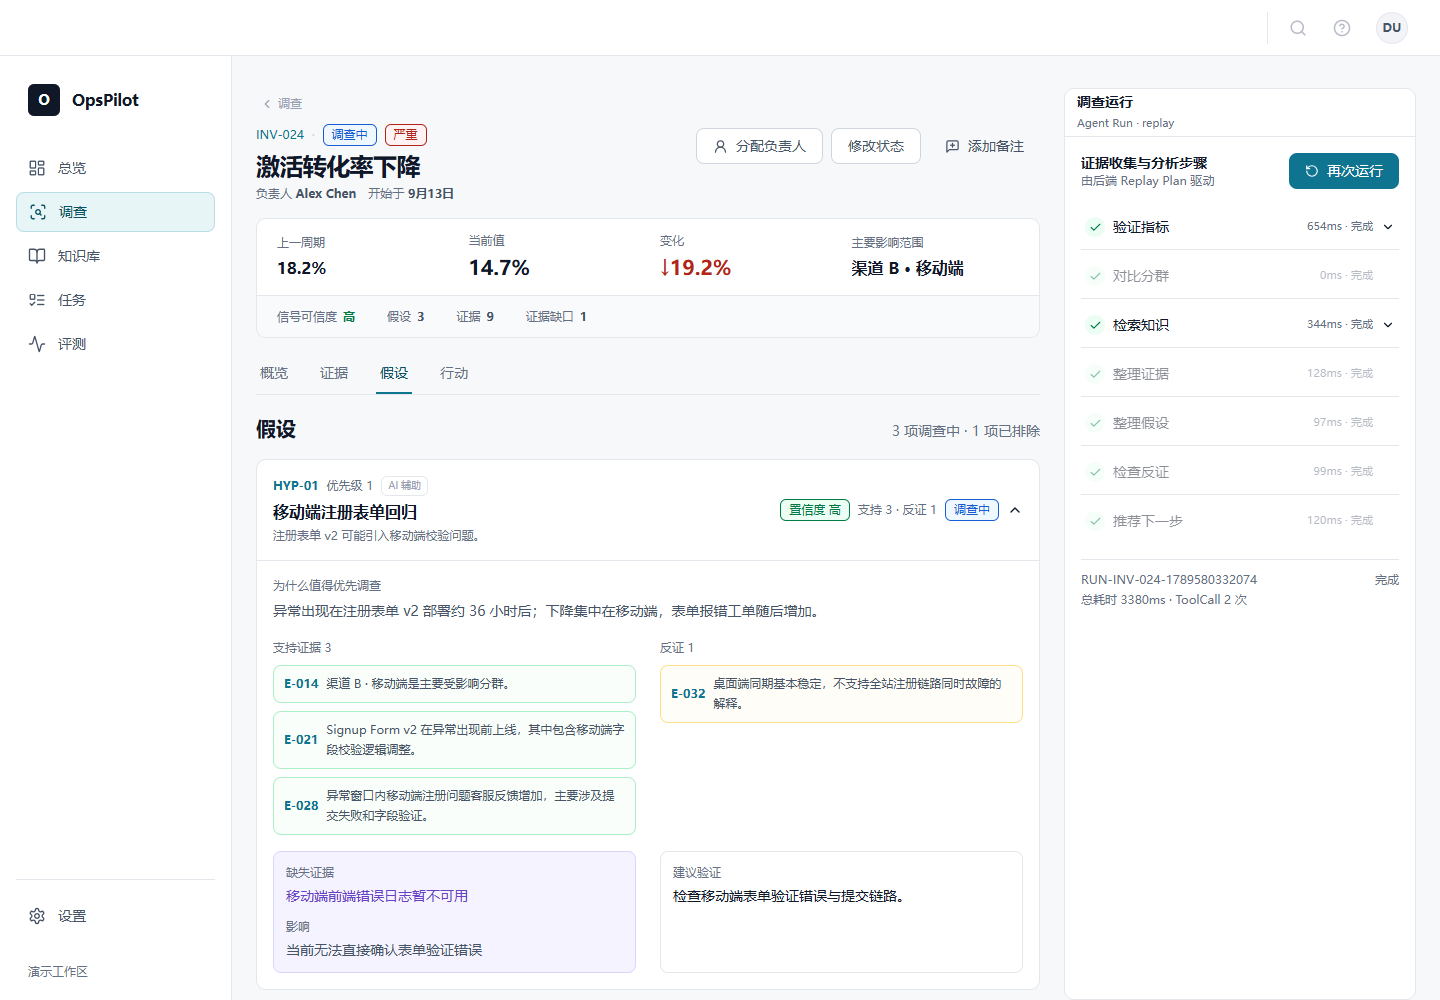
HYP-01 假设、支持证据、反证和证据缺口真实界面
HYP-01 · 移动端注册表单回归

HYP-01 · 最高优先级

移动端注册表单回归

置信度ConfidenceHigh

状态Status进行中Active

支持证据Supporting
3 · E-014 · E-021 · E-028
限制证据Limiting
1 · E-032
证据缺口Evidence Gap
缺少移动端前端错误日志
假设不等于结论Hypothesis ≠ Conclusion相关性不等于因果关系Correlation ≠ Causation

两种不同的“可信度”Two Different Confidence Signals

证据可靠性Evidence Reliability

判断来源是否可追溯、可靠且通过数据质量检查。E-021 · 高

假设置信度Hypothesis Confidence

综合支持证据、限制证据与证据缺口后的判断。HYP-01 · 高

证据可靠性 ≠ 假设置信度Evidence Reliability ≠ Hypothesis Confidence

06 · 智能体运行

智能体是调查过程,不是聊天窗口。

公开作品演示使用确定性回放(Deterministic Replay),保证稳定、可重复且不依赖公开 API Key;query_metrics 与 search_knowledge 仍真实经过工具运行时。

  1. 01

    验证指标数据

  2. 02

    定位主要受影响范围

  3. 03

    搜索业务上下文

  4. 04

    整理调查证据

  5. 05

    评估调查假设

  6. 06

    检查反证与证据缺口

  7. 07

    推荐下一步行动

OpsPilot Agent Panel 七步调查运行真实界面
确定性回放 · 七步调查运行 · 工具调用持久化Replay · 7-step Agent Run · Tool Calling Persistence
query_metrics

结构化指标查询与分群定位。

search_knowledge

内部知识检索与引用。

create_task

改变工作区状态,必须经过审批。

07 · 人工介入

AI 可以建议,但不能越权执行。

建议与行动分离。智能体负责提出建议;后端与人工审批共同决定是否改变工作区状态。

建议Recommendation创建行动Create Action需要审批Approval Required人工审批Human Approval任务 · TASK-048Task
创建任务审批弹窗真实界面
未审批执行 → ACTION_REQUIRES_APPROVAL
审批后 TASK-048 创建状态真实界面
审批后创建 TASK-048 · 来源调查 INV-024Source Investigation

08 · 结果观察

行动之后发生了什么?

结果观察记录行动后的指标变化,同时明确它不单独证明任务与结果之间存在因果关系。

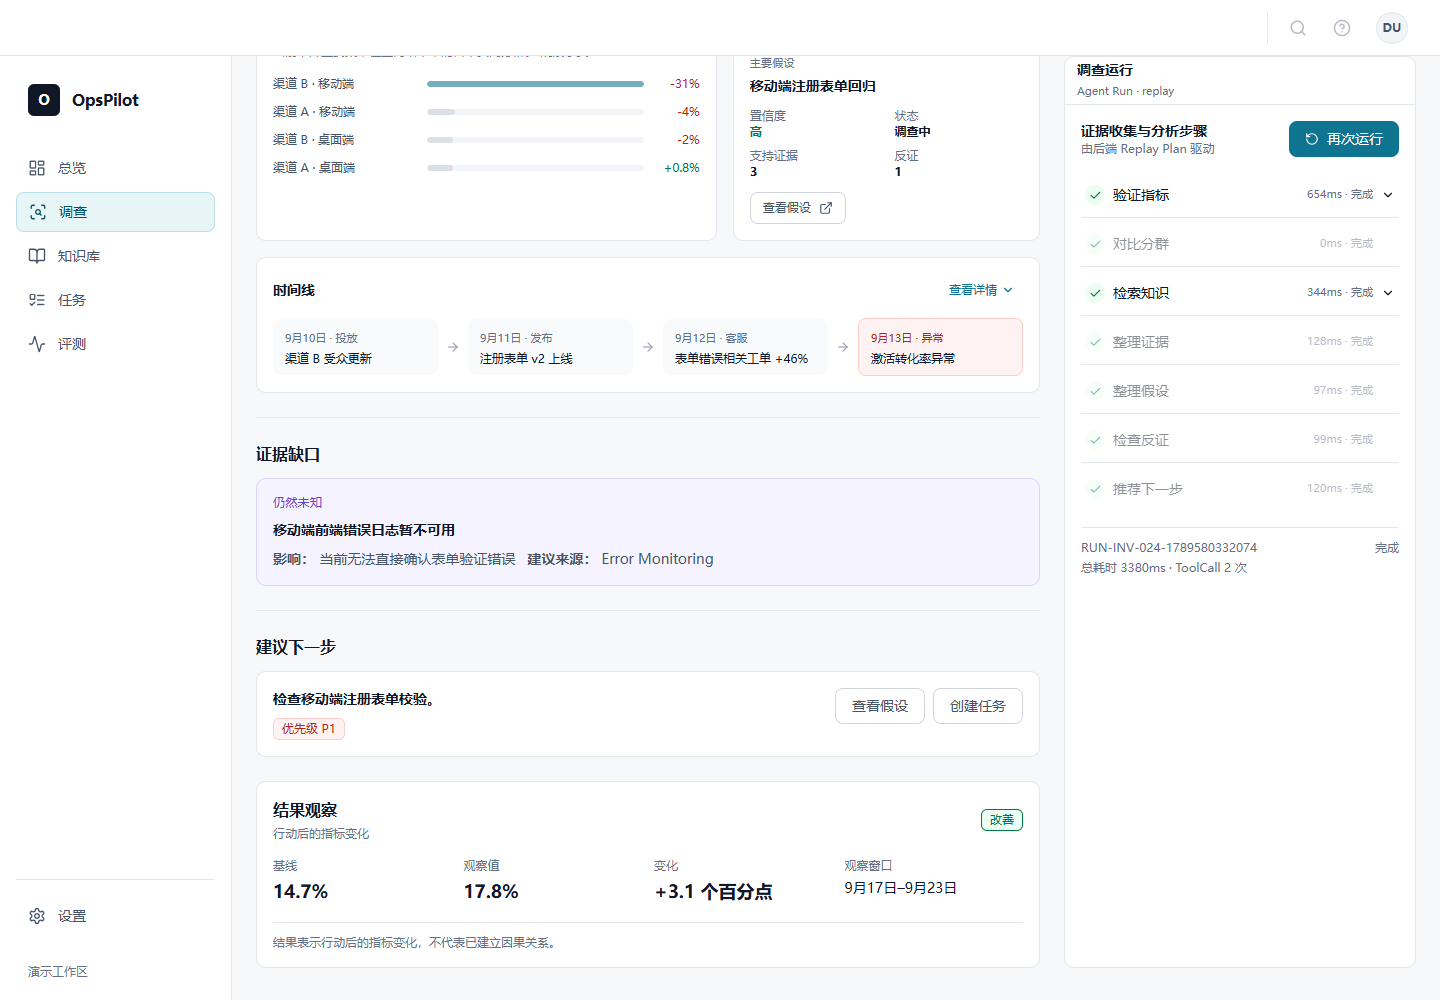
异常期14.7%观察期17.8%+3.1pp · 改善 Improved精确值:14.699% → 17.75% · +3.051pp
OpsPilot 结果观察真实界面
结果观察 Outcome Monitoring · 指标观察结果

数据质量门槛Data Quality Gate

观察窗口未通过数据质量检查时,即使指标上升,结果也标记为无法判断 Inconclusive,而不是“已改善”。数据质量优先同时适用于调查与结果观察。

行动后的指标变化不单独证明该任务与结果之间存在因果关系。

09 · 系统评测

不只让智能体跑起来,还要验证它是否按规则工作。

OpsPilot 评测工具选择、失败停止、引用、声明来源、审批安全与重复运行,不把它包装成大模型基准测试。

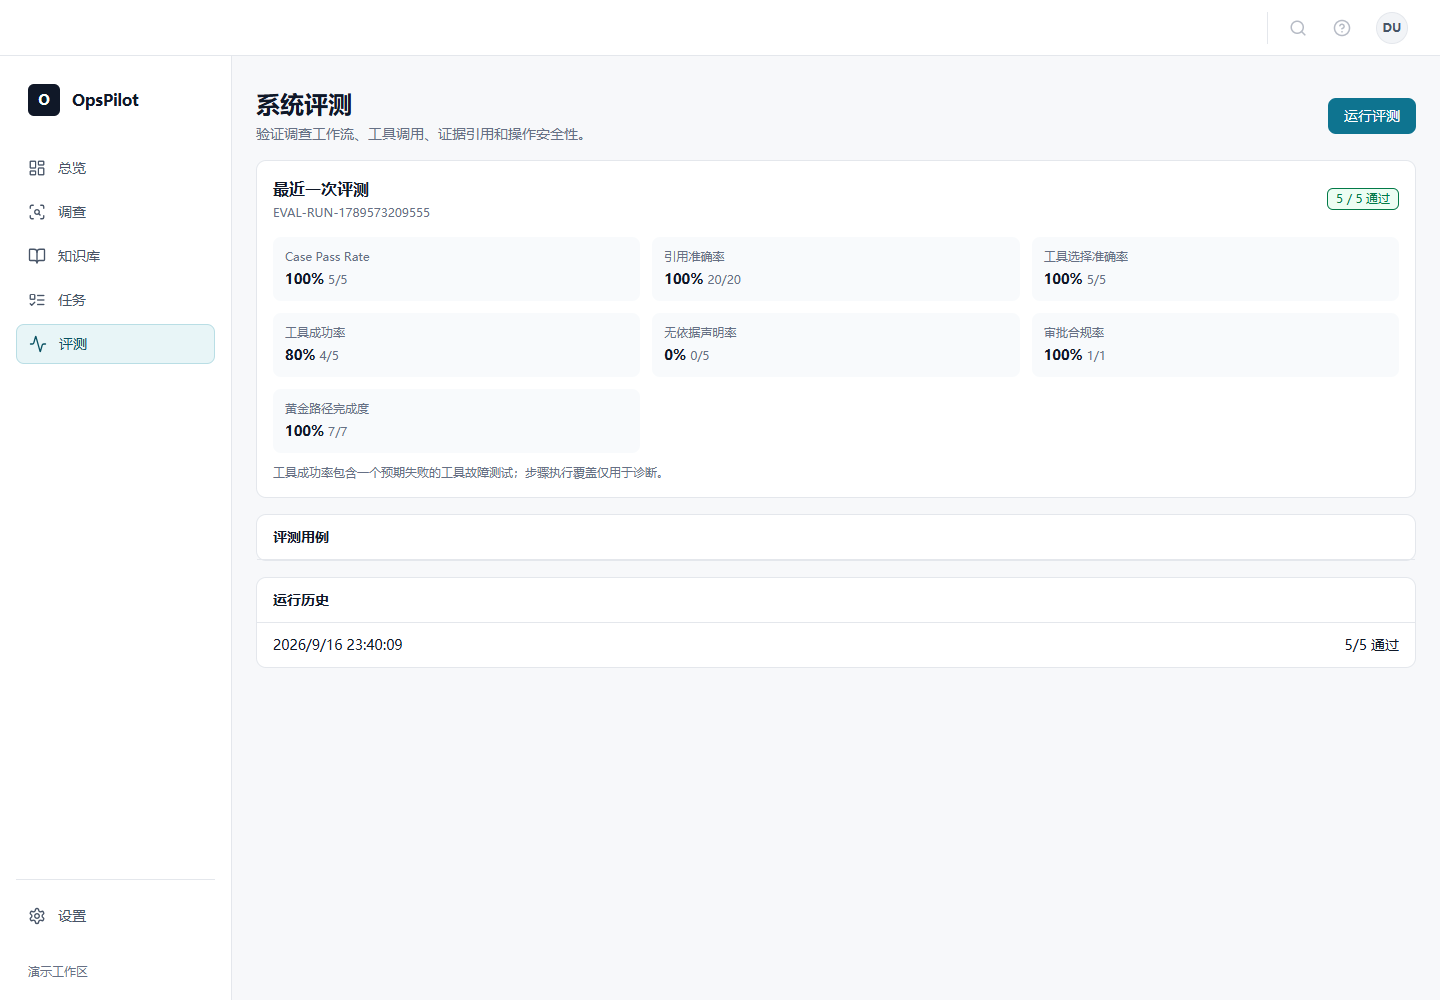
最新评测结果5 / 5

场景通过Cases Passed

20 / 20引用准确率Citation Accuracy
5 / 5工具选择准确率Tool Selection
4 / 5工具成功率Tool Success
0 / 5无依据声明Unsupported Claims
1 / 1审批合规率Approval Compliance
7 / 7黄金路径完成度Golden Path
OpsPilot 系统评测 5/5 真实界面
真实最新结果 · 5 / 5 评测场景通过5 / 5 Eval Cases Passed

工具成功率为 4 / 5:一次失败来自预期的工具失败测试,该评测场景本身正确通过。

正常调查流程指标工具失败知识证据不足审批安全幂等性回归

不同声明,需要不同来源Structured Claim Types

观测事实Observed Fact

关联 ToolCall 或正式证据

推断Inference

可追溯到事实或证据

假设Hypothesis

关联证据关系或明确证据缺口

建议Recommendation

关联假设或证据缺口

系统不是要求 AI “说得谨慎”,而是要求每类声明拥有可检查的来源关系。

10 · 架构与可靠性

一条可追踪、可停止的服务链路。

技术结构服务于调查可靠性:浏览器经 Next.js API 进入领域服务、工具运行时与数据仓储层,服务端凭证不进入浏览器。

AI 负责理解和建议,确定性系统负责计算、权限与执行。

AI interprets and recommends. Deterministic systems calculate, authorize and execute.

AI 负责AI Responsibility
  • 理解自然语言
  • 检索上下文
  • 整理证据
  • 提出假设
  • 推荐下一步
确定性系统负责Deterministic System Responsibility
  • 指标计算
  • 数据质量判断
  • 权限检查
  • 审批状态
  • 任务创建
  • 数据库约束

query_metrics 由 Metric Service 完成真实计算;create_task 只在后端确认审批通过后执行。智能体不能决定审批结果、任务状态、结果判断或权限。

前端FrontendNext.js API领域服务Domain Services智能体运行时Agent Runtime确定性回放 · 实时模式预留
Replay · Live Reserved
工具Toolsquery_metrics · search_knowledge · create_task数据仓储层RepositoriesSupabase PostgreSQL
证据可追溯Evidence Traceability数据质量门槛Data Quality Gate审批门槛Approval Gate幂等性Idempotency失败状态Failure States系统评测System Evals

失败路径证明Failure Proof

METRIC_NOT_ALLOWED停止后续步骤 · 失败
DEMO_QUERY_NOT_AVAILABLE不伪造引用 · 部分完成
ACTION_REQUIRES_APPROVAL未审批时 create_task 必须失败
11 · 我的职责

由人主导产品决策,AI 辅助实现。

产品定义、交互逻辑、数据结构、智能体行为规则与评测标准由我主导;实现阶段使用 AI 编码工具辅助完成工程落地与测试。

产品定义Product Definition

研究归纳Research Synthesis领域建模Domain Modeling

体验设计Experience Design

用户体验 / 信息架构UX / IA前端产品设计Frontend Product Design

AI 产品系统AI Product System

智能体流程Agent Workflow工具结构Tool Schema安全规则Safety Rules评测设计Evaluation Design

实现与验证Implementation & Validation

AI 辅助实现AI-assisted Implementation测试与迭代Testing & Iteration

技术栈Tech Stack

Next.js · React · TypeScript · Supabase / PostgreSQL · pgvector · Zod

12 · 关键取舍

先定义正确行为,再增加系统自由度。

01

不做通用聊天No general AI Chat

业务调查需要结构化过程和持久化对象,不是一次性聊天答案。

02

证据与假设分离Evidence / Hypothesis Separation

事实来源和解释不能混为一体。

03

建议与行动分离Recommendation / Action Separation

AI 建议不能自动等于业务执行。

04

数据质量优先Data Quality First

错误数据上的智能分析没有意义。

05

公开演示使用确定性回放Portfolio Replay

保证招聘场景稳定、可重复,并避免公开 API Key 依赖。

06

先评测,再考虑实时大模型Evals before Live LLM

先定义正确行为,再增加模型自由度。

13 · 边界与限制

公开演示的稳定性来自清晰边界,而不是隐藏限制。

回放运行时不是实时大模型智能体Replay Runtime is not a Live LLM Agent

知识数据集是策展的演示数据集Curated Demo Knowledge Dataset

公开演示使用共享工作区Shared Demo Workspace

仅设置轻量频率限制Lightweight Rate Limit

暂未接入真实企业连接器No live Slack / Jira / CRM Connector

结果变化不是因果实验Outcome is not a causal experiment

从异常到证据支撑的行动From anomaly to evidence-backed action

从业务异常,到有证据支撑的行动。

返回作品集

Continue exploring

继续查看相关实践与完整经历。

Resume
继续查看 LootPilot

Contact

联系我

如果你想聊产品设计、数字产品或合作机会,可以通过下面的方式联系我。